Software Engineering with AI
AIとのソフトウェア開発に
ウォーターフォールを持ち込む
コンテキストゼロから始まるAIを、
一人前のエンジニアとして動かすための仕組み
towada
AIセッションは コンテキストゼロ から始まる
新しいセッションのたびに、
AIは 「オンボーディングを受けただけの新人」 になる。
与えられるのはせいぜい概要と基本情報だけ。
プロジェクトの背景も、過去の意思決定も、何も持っていない。
コンテキストエンジニアリングだけでは 足りない
「新しい要件は何か」「新しい仕様は何か」「ビジネス要件は何か」を
きちんと理解させた上で動かすことは前提。
でもドキュメントを渡すだけでは、
影響範囲が分からないまま、AIはコードを書き始める。
読む能力だけでなく、
影響範囲を辿る仕組みが要る。
これは 人間の多重下請け開発 と同じ構造
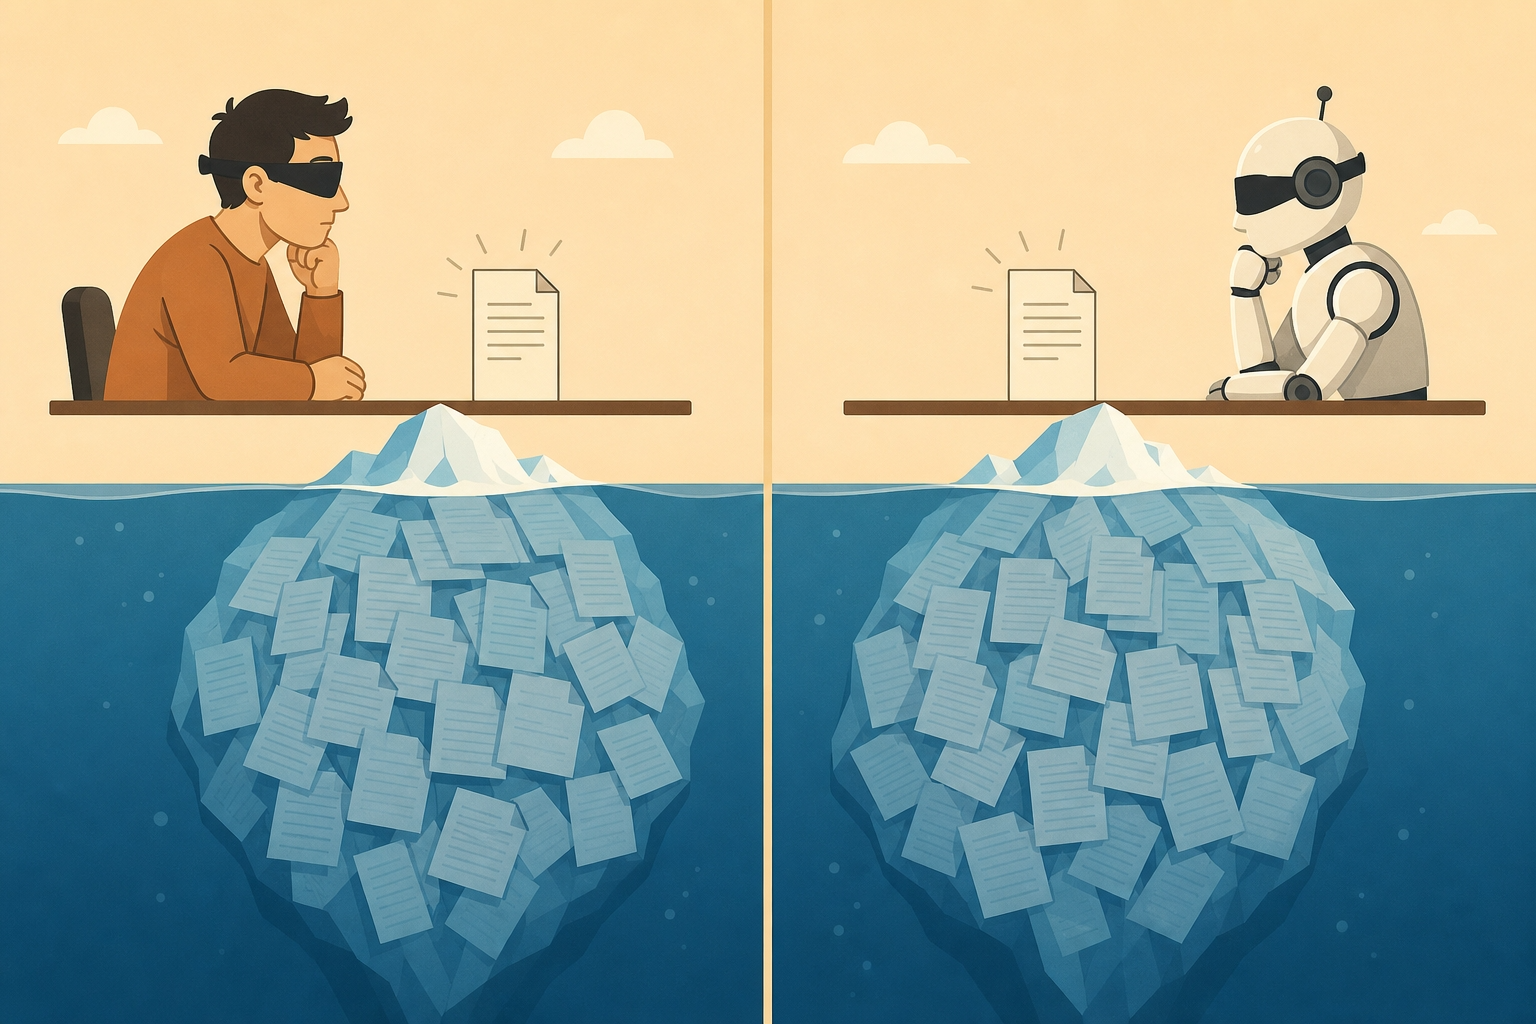
実装者(下請け)
AI(コンテキスト不足)
- 目の前のドキュメントだけ見る
- 与えられたタスクだけ実装する
- 影響範囲に気づいていない
- 仕様の矛盾も見えない
レビュアや上流担当者だけが
「本当の要件・仕様・影響範囲」を知っている。
AIも同じ失敗をする。
ドキュメントは 縦方向 だけではない
VERTICAL: 従来の縦のつながり
要件定義
↓
仕様
↓
設計
↓
実装
↓
テスト
HORIZONTAL: 横断的な影響範囲
業務フロー A
業務フロー B
業務フロー C
↘ ↓ ↙
共通DB / 共通API / 共通処理
DBや共通マスタは複数の業務フローから参照される。
ひとつの業務だけを見ても影響範囲は把握できない。
GraphDB で関係性を管理する
NODES: 資産をノードとして管理
Meeting  →  Decision  →  ChangeRequest
Requirement  →  Specification
Screen  →  API  →  DBTable
SourceFile  →  Function
TestCase  →  PullRequest
EDGES: 関係性をエッジで定義
Decision    → creates →  ChangeRequest
ChangeRequest → satisfies → Requirement
Requirement  → defined_by → Spec
Spec         → implemented_by → SourceFile
API          → reads/writes → DBTable
TestCase     → verifies → Requirement
GraphDBは「本文を全部入れる場所」ではなく、「何と何がつながっているか」を管理する地図。
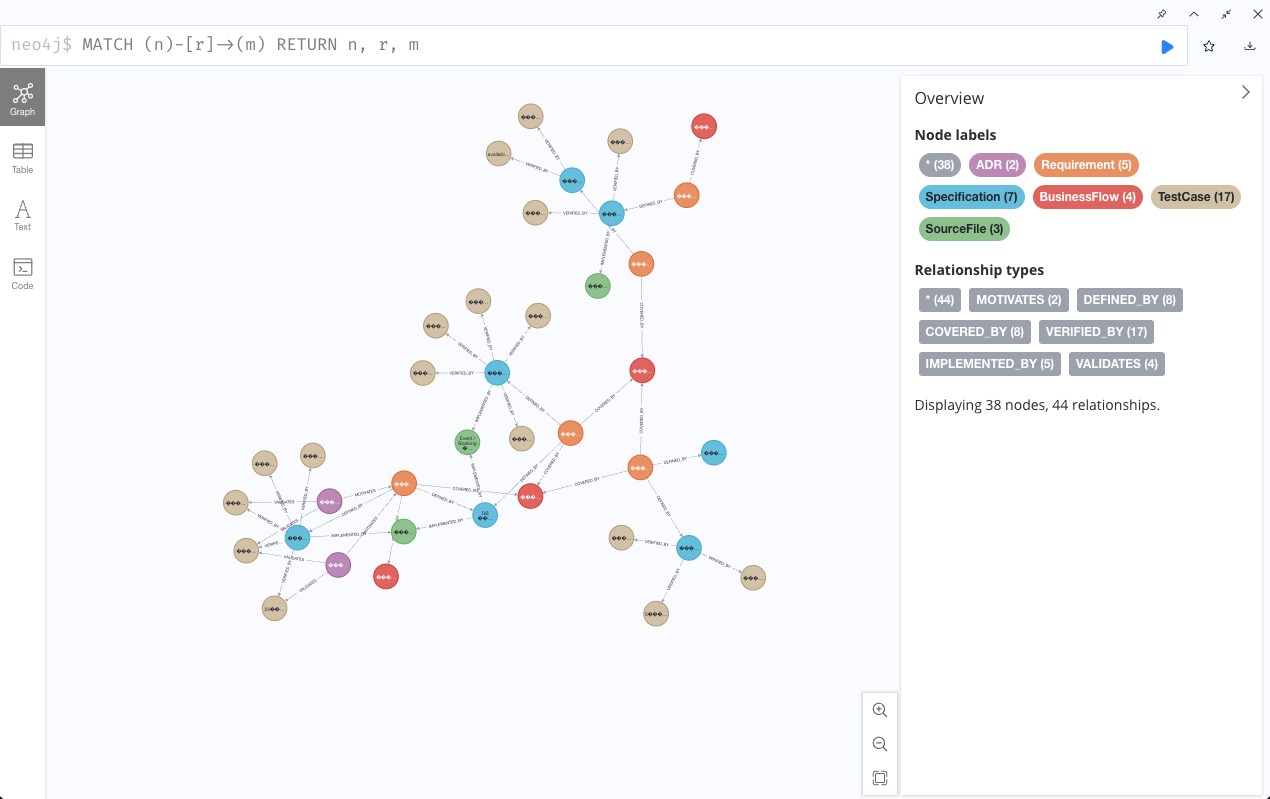
実際に構築した トレーサビリティグラフ
STATS: 今回のサンプルプロジェクト
ADR × 2 ノード
Requirement × 5 ノード
Specification× 7 ノード
BusinessFlow × 4 ノード
TestCase × 17 ノード
SourceFile × 3 ノード
計 38 ノード / 44 エッジ
- MOTIVATES … ADR → REQ
- DEFINED_BY … REQ → SPEC
- COVERED_BY … SPEC → BF
- VERIFIED_BY … TC → SPEC
- IMPLEMENTED_BY … src → SPEC
- VALIDATES … src → TC
必要なドキュメントの 理論値
「とりあえず増やす」ではなく、どの機能が動くのに何件必要かを先に計算した。
LAYERS: 階層と最小件数
ADR(なぜ)        ×  2 件  ← 設計判断の根拠
REQ(何を)        ×  5 件  ← 横断検索が意味を持つ量
SPEC(どのように)  ×  7 件  ← DBスキーマ・エラー標準を含む
BF(業務の流れ)    ×  4 件  ← 通知・主催者フローを含む
TC(検証)         × 14 件  ← 各 SPEC に最低 2 件
src(実装)        ×  3 件  ← 要件に対応するモジュール単位
PR               ×  1 件  ← スキル連携の証跡
WHY: 数値の根拠
- REQ が 5 件ないと変更影響が横断しない
- ADR がないと「なぜその仕様か」を遡れない
- DBスキーマ SPEC がないと、コード変更なしのスキーマ変更を検知できない
- TC が 0 だと
/trace-test が機能しない
- 横断する SPEC(認証など)がないと共通影響が見えない
少なすぎると検索が自明な結果しか返さない。多すぎると誰も続けない。この数字はその境界を試行錯誤して探した結果。
普通の RAG では足りない → GraphRAG
普通のRAGは「似ている文章を拾う」だけで、グラフの関係は辿れない。
ARCHITECTURE: 2 段検索の構成
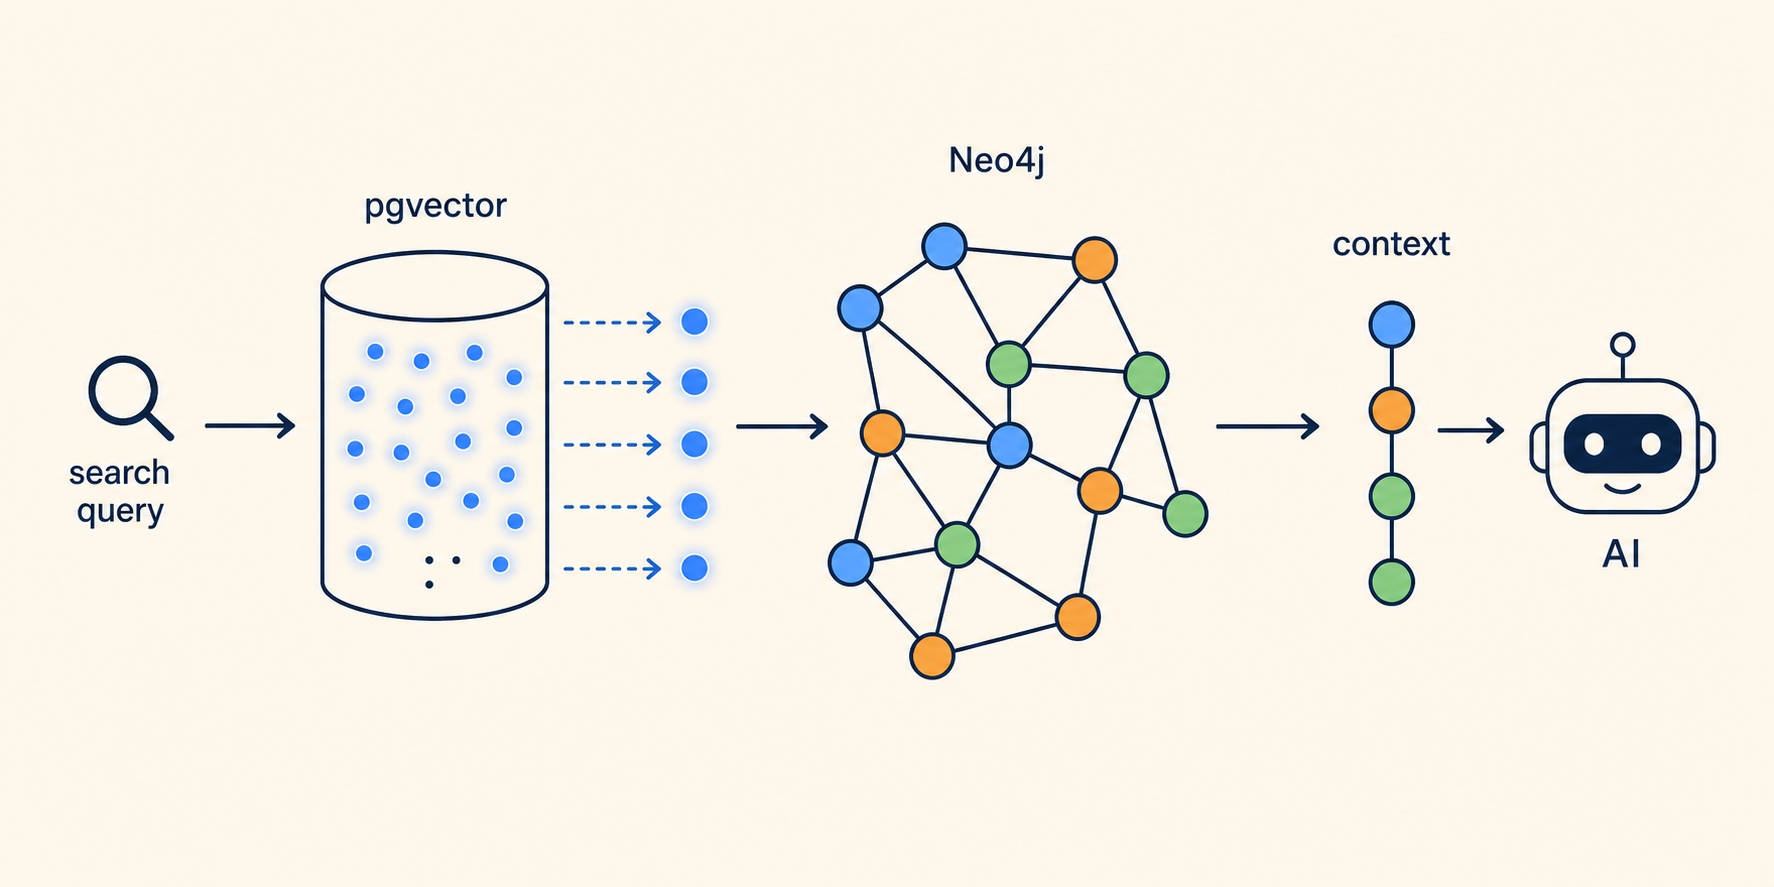
ドキュメントが増えても、AIに渡すのは関連する数件だけで済む。
最初の成果物は 変更影響レポート
AIにいきなりコードを書かせない。
コードレビューの前に、理解レビューを行う。
# 変更影響レポート

## 変更要求 / 背景・理由
## 関連要件 / 関連仕様
## 影響する業務フロー
## 影響する画面 / API / バッチ
## 影響する DB テーブル / カラム
## 影響するソースコード / テスト
## 不明点 / 仕様矛盾の可能性
## 実装方針案 / テスト方針案
テストは 品質保証 だけではなく 仕様対応の可視化
ドキュメントだけでは見えてこなかった変更の影響調査。
テスト通過 ≠ 仕様理解の証明。
AIが誤解したまま生成したテストは、その誤解ごとパスする。
テストと仕様書の対応は、人間がレビューして確認する。
A 要件テスト
変更がビジネス要件を満たしているか
例: 本人確認未完了は本審査申込不可
B 仕様テスト
仕様書の分岐・入出力を満たすか
例: status=pending → ボタン非活性
C 回帰テスト
同じDB・API・共通関数を使う
別業務を壊していないか
D E2E トレーサビリティ
DB変更が画面まで正しく届くか
DB → Backend → API → Store → UI
PR は単なる差分ではなく 意思決定の集約点
PR に含めるもの
- 発端となった会議・依頼・決定
- 対応する変更要求
- 対応する要件・仕様
- 影響範囲(業務・画面・API・DB)
- 修正したドキュメント
- 修正したコード
- 追加・修正したテスト
- テスト結果
- AI レビュー観点 / 人間レビュー観点
PR の難易度分類
Level 3
複数画面 / API / DB に影響
PR 履歴が ADR になる
全 PR に十分な情報があれば、
PR 履歴そのものが意思決定履歴になる。
PR を辿れば分かること:
なぜ変更したのか → 誰が決めたのか → どの要件か → どの仕様か → どのコードか → どのテストで証明したか
ADR は独立文書として管理する必要はない。
PR から自動生成できるビューとして扱える。
技術スタック (MVP 構成)
✓ Neo4j
要件・仕様・コード・テストの関係管理。影響範囲を辿る地図。
ADR→REQ→SPEC→TC の 3 ホップ実装済み
✓ PostgreSQL + pgvector
文書 chunk・embedding・テスト結果・メタデータの保管。
スキーマ + インデクサー実装済み
✓ Python GraphRAG
pgvector 近傍検索 → Neo4j グラフ展開の 2 段検索。
graphrag.py として実装済み
✓ Claude Code Skills
impact-report / spec-check / trace-test / waterfall-pr / cross-review / reverse-doc
6 スキル実装済み
▷ FastAPI
AI 向け Traceability API。グラフ探索を AI から呼べる形に。
▷ MCP
Claude Code から安全に GraphRAG・Traceability API を呼ぶ接続口。
AI レビューは 多観点チェックリスト として使う
同一モデル・同一セッションでの実行のため「独立したレビュア」ではない。
業務妥当性・意思決定の最終判断は必ず人間が行う。
+ 異なるモデル(Codex)で敵対的クロスチェックを加える。
Requirements
要件と仕様の整合性を見る
段階的な 実装フェーズ
最初から完璧な GraphRAG を作らない。段階的に育てる。
Phase 1
PR テンプレート整備 + 変更影響レポートを AI に必ず出させる
Phase 2
ドキュメント ID・要件 ID・テスト ID を付与
Phase 3
GitHub Actions で PR 差分収集 → PostgreSQL に文書 chunk 保存
Phase 4
Neo4j で要件・仕様・コード・テストを接続
Phase 5〜7
GraphRAG 化 → AI ロール別レビュー自動化 → MCP 化
今日の 現在地
BUILT: 実装済み
- Claude Code スキル × 6(impact-report, spec-check, trace-test, waterfall-pr, cross-review, reverse-doc)
- Docker 環境(Neo4j + PostgreSQL/pgvector)
- サンプルドキュメント理論値セット(ADR×2 / REQ×5 / SPEC×7 / BF×4 / TC×14)
- Neo4j グラフ投入・可視化(38ノード、44エッジ)
- pgvector インデクサー(markdown→chunk→embedding→DB)
- GraphRAG クエリ層(pgvector近傍 + Neo4jグラフ展開)
NEXT: 次フェーズ
- FastAPI で GraphRAG を REST API 化
- MCP サーバーとして Claude Code に接続
- GitHub Actions で PR 差分 → 自動インデックス更新
- 実プロジェクトへのロールアウト
Phase 1(スキルだけ)は今日から使える。
インフラは段階的に育てる。
既存プロジェクトから始める場合 (ドキュメントなし)
まず /reverse-doc でコードからドキュメントを逆生成して出発点を作る。
STEP 1: コードからドキュメントを逆生成
/reverse-doc
docs/business-flows.md
docs/api-spec.md
docs/db-schema.md
docs/requirements-draft.md
生成物はすべて 「⚠ コードから逆生成」 タグ付き。
人間が正しさを確認してから使う。
STEP 2: インフラにインデックス投入
cd infra && docker compose up -d
python3 infra/load_sample_data.py
python3 infra/indexer.py
python3 infra/graphrag.py "認証に関連する仕様は?"
日常の開発フロー (コーディング前 → PR)
コーディング前
/impact-report → 変更影響レポートを生成。
AIが「この変更はREQ-002・SPEC-002・BF-001/002・TC-BOOK-001〜005に影響する」と判断。
出力は .ai-trace/impact-report.md に保存される。
仕様確認
/spec-check → 要件と仕様の整合性確認。
矛盾・未定義の箇所を列挙。人間が確認して仕様を確定させる。
実装後
/trace-test → テストケースを仕様 ID 付きで生成。
TC-BOOK-004 verifies REQ-002-02, SPEC-002, covers_api=['/bookings/{id}']
PRレビュー前
/cross-review → 多観点チェックリスト(要件・影響・テスト・コード・回帰)
+ Codex による敵対的レビュー
PR作成
/waterfall-pr → .ai-trace/ の情報を統合して PR 本文を自動生成。
gh pr create → GitHub Actions が影響範囲コメントを自動投稿。
PR を出すと GitHub Actions が自動でコメントする
sample-project/docs/ または src/ に変更があると自動実行される。
自動コメントの内容
## トレーサビリティ影響レポート

### 変更されたファイル
- REQ-002-booking.md
- SPEC-002-booking-api.md

### 影響するドキュメント
| ドキュメント | 参照している変更 |
| ADR-001     | REQ-002, SPEC-002 |
| BF-001      | REQ-002           |
| SPEC-006    | REQ-002           |

### 確認チェックリスト
- [ ] 仕様変更に対応したテスト更新
- [ ] /impact-report スキルで確認
2 つの Workflow
- doc-lint.yml
命名規則・必須セクション・クロスリファレンスを自動チェック。壊れた参照があれば CI が落ちる。
- pr-impact.yml
変更ドキュメントの逆引き解析で「何に波及するか」を自動コメント。再プッシュで更新される(重複しない)。
ドキュメントを変えるたびに
「この変更が何に影響するか」が自動で可視化される。
まとめ
🗺️
GraphDB で影響範囲を辿る
ドキュメント・コード・テストを地図として管理
🔍
GraphRAG で必要本文だけ読む
コンテキスト圧迫せずに正確な情報を届ける
✅
テストで仕様対応を可視化する
品質保証だけでなく仕様との対応関係を明示。人間レビューとセットで使う
📋
PR に意思決定から検証まで封じ込める
会議→要件→仕様→実装→テスト→レビューを一体化
AI に大量のコンテキストを詰め込むのではなく、
AI が根拠へ到達できる構造を作る。